
Keynote Speech
9.4 09:20-12:00
扫码观看直播/回放

裴昶华
中国科学院计算机网络信息中心副研究员
中国科学院计算机网络信息中心副研究员,国科大杭州高等研究院岗位教授,博士生导师,学位委员会成员,百人计划引进人才,承担国家发改委人机物融合信息基础设施创新与实验平台智能运管创新平台研制建设,中国科学院“十四五”科教基础设施建设专项智能运管项目,国家自然科学基金青年科学基金项目,国家重点研发计划青年科学家项目。在SIGCOMM, ICML,SIGKDD,WWW,FSE,INFOCOM等国内外顶级会议及期刊发表论文50余篇,Google Scholar总引用6000+,多篇论文获得最佳论文奖及提名。
待定
待定
从“搭建爽”到“可运维”:AgentOps 让多智能体系统走向工程化
内容大纲:
1. 智能体正在进入生产,但可靠性仍是短板
1. 智能体正在进入生产,但可靠性仍是短板
介绍 Agentic AI 的快速发展,以及智能体从实验性 Demo 走向复杂业务系统的趋势。智能体能够自主规划、调用工具和协同执行任务,但在复杂领域任务中仍然容易出现幻觉、错误规划、工具调用失败、无限循环和任务半途终止等问题。
本部分的关键判断是:智能体的能力已经足够令人兴奋,但可靠性还没有达到大规模生产的要求。
本部分的关键判断是:智能体的能力已经足够令人兴奋,但可靠性还没有达到大规模生产的要求。
2. 什么是 AgentOps
首先区分两个概念。OpsAgent 是使用 Agent 运维传统的软件系统;AgentOps 则是对智能体系统本身进行开发、评测、监控、诊断、恢复和持续优化。
传统运维通常围绕监控、异常检测、根因分析和故障修复展开。AgentOps 需要把这些能力扩展到模型、记忆、推理过程、工具调用、智能体协作和任务轨迹等层面。
传统运维通常围绕监控、异常检测、根因分析和故障修复展开。AgentOps 需要把这些能力扩展到模型、记忆、推理过程、工具调用、智能体协作和任务轨迹等层面。
3. 智能体系统为什么比传统系统更难运维
从传统微服务系统与多智能体系统的差异切入,说明 AgentOps 面临的三类根本变化:
1)数据不再天然可信:指标、日志和 Trace 通常描述系统事实,而 Agent 产生的计划、判断和行动本身可能就是错误的。
2)故障不再只发生在服务节点:问题可能来自模型推理、Prompt、规划、记忆、工具调用、环境状态或智能体之间的通信。
3)故障处理不再是一次性动作:定位根因之后,系统往往还需要多轮评测、Prompt 优化、回滚和 A/B 测试。
2)故障不再只发生在服务节点:问题可能来自模型推理、Prompt、规划、记忆、工具调用、环境状态或智能体之间的通信。
3)故障处理不再是一次性动作:定位根因之后,系统往往还需要多轮评测、Prompt 优化、回滚和 A/B 测试。
本部分的结论是:AgentOps 不是把传统 AIOps 简单套在 Agent 上,而是要重新定义“系统状态”和“故障”。
4. AgentOps 的核心能力:看得见、判得准、修得好
4.1 看得见:建立面向智能体的可观测性
除了指标、日志和 Trace,还需要记录模型参数、Attention Map、Logits、Prompt、Response、Thought、Reflection、Reasoning,以及 Agent 的记忆、环境、运行时配置、Checkpoint、工具调用和 MCP/A2A 交互关系。
4.2 判得准:识别真正的异常与故障根因
介绍多模态监控数据融合、模型数据检测、Checkpoint 状态分析,以及“Who & When”类故障归因方法,重点回答两个问题:哪一个 Agent 引入了失败?失败发生在整个任务的哪一步?
4.3 修得好:支持恢复、回滚与持续优化
说明智能体系统的修复通常是多步骤、多轮次的过程,包括失败路径定位、Agent 或任务状态回滚、Prompt 和策略优化、A/B 测试、多智能体并行调度、上下文共享与 KV-Cache 优化。
5. 从故障归因到闭环优化
将报告中的研究成果组织成一条清晰的技术演进路线:
1)多模态故障检测:融合指标、日志、Trace、调用图和系统行为,识别复杂系统中的异常状态。
2)智能体失败归因:基于任务轨迹分析责任 Agent 和失败步骤,建立面向多智能体系统的 Benchmark 与数据集。
3)结构化错误知识复用:从历史失败轨迹中提炼错误模式,在线检索相似案例,辅助新的故障诊断。
4)AgentOps 闭环优化:将监控、检测、定位、恢复和评测连接起来,使系统能够持续改进,而不是只在故障发生后被动响应。
本部分的核心观点:AgentOps 的终点不是发现更多问题,而是让系统具备持续学习和持续变好的能力。
1)多模态故障检测:融合指标、日志、Trace、调用图和系统行为,识别复杂系统中的异常状态。
2)智能体失败归因:基于任务轨迹分析责任 Agent 和失败步骤,建立面向多智能体系统的 Benchmark 与数据集。
3)结构化错误知识复用:从历史失败轨迹中提炼错误模式,在线检索相似案例,辅助新的故障诊断。
4)AgentOps 闭环优化:将监控、检测、定位、恢复和评测连接起来,使系统能够持续改进,而不是只在故障发生后被动响应。
本部分的核心观点:AgentOps 的终点不是发现更多问题,而是让系统具备持续学习和持续变好的能力。
6. 面向未来的 AgentOps
6.1 运维能力必须原生内置,而不是外挂补丁
智能体系统的运维子系统应与应用共同设计,成为软件架构的一部分,而不是系统上线之后再叠加的辅助工具。
6.2 可信度必须可观测
不同类型的智能体需要定义不同级别的可信边界,并通过运行时断言、日志和监控记录可信度下降、违规和风险逼近过程。
6.3 可观测性标准要尽早建立
行业需要形成统一的运行时记录规范,覆盖模型状态、Agent 状态、记忆、交互、工具调用、协议调用和推理过程,从而支持可定位、可追溯、可恢复的智能体系统。
智能体系统的运维子系统应与应用共同设计,成为软件架构的一部分,而不是系统上线之后再叠加的辅助工具。
6.2 可信度必须可观测
不同类型的智能体需要定义不同级别的可信边界,并通过运行时断言、日志和监控记录可信度下降、违规和风险逼近过程。
6.3 可观测性标准要尽早建立
行业需要形成统一的运行时记录规范,覆盖模型状态、Agent 状态、记忆、交互、工具调用、协议调用和推理过程,从而支持可定位、可追溯、可恢复的智能体系统。
7. 结尾核心观点
1. 智能体系统的竞争,最终不只是模型能力的竞争,也是系统可靠性的竞争。
2. AgentOps 要解决的,是如何让智能体系统看得见、说得清、找得到、修得好。
3. 下一代智能软件的运维能力,应当从第一天起就被设计进系统内部。
1. 智能体系统的竞争,最终不只是模型能力的竞争,也是系统可靠性的竞争。
2. AgentOps 要解决的,是如何让智能体系统看得见、说得清、找得到、修得好。
3. 下一代智能软件的运维能力,应当从第一天起就被设计进系统内部。
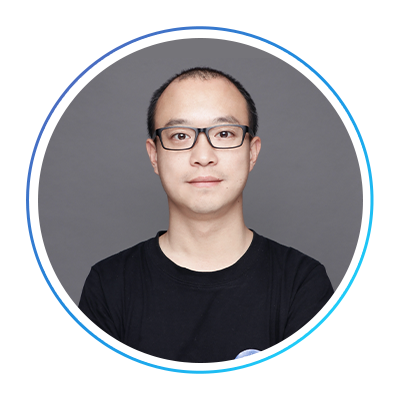
茹炳晟
腾讯研究院 高级技术顾问
中国计算机学会TF多智能体系统SIG副主席,中国计算机学会TF数据科学与知识工程SIG执委,“软件研发效能度量规范“标准核心编写专家,中国商业联合会互联网应用技术委员会智库专家,中国通信标准化协会TC608云计算标准和开源推进委员会云上软件工程工作组副组长,腾讯云架构师技术同盟入会主席,年度IT图书最具影响力作者,多本技术畅销书作者,著作有《软件研发效能提升之美》《现代软件测试技术之美》《测试工程师全栈技术进阶与实践》《多模态大模型技术原理与实战》《高效自动化测试平台:设计与开发实战》《软件研发效能提升实践》《软件研发效能权威指南》《现代软件测试技术权威指南》《高质效交付》《代码之外:软件工程师成长手记》等,译作有《软件设计的哲学》《整洁架构之道》《持续架构实践》《构建Agentic AI系统》《大模型驱动的软件测试:从理论到实践》《平台工程》《企业架构决策:战略框架与实施指南》《AI领导力》《现代软件工程》《计算机科学通识:计算思维培养与多学科问题解决实践》《DevOps实践指南(第2版)》《精益DevOps》《基础设施即代码-模型驱动的DevOps》等,国内外各大技术峰会的联席主席,出品人和Keynote演讲嘉宾。公众号“茹炳晟聊软件研发”主理人。
待定
待定
LLM时代Palantir FDE模式在中国企业落地的实战心得与“祛魅”之路
1. Palantir FDE的概念由来与底层逻辑
2. 为什么Agent的出现极大推动了FDE的爆发增长
3. 为什么Palantir FDE的经验并不适用于国内软件企业
4. 国内软件企业需要什么样的FDE实践
5. FDE在国内企业落地过程中的常见误区与应对策略
2. 为什么Agent的出现极大推动了FDE的爆发增长
3. 为什么Palantir FDE的经验并不适用于国内软件企业
4. 国内软件企业需要什么样的FDE实践
5. FDE在国内企业落地过程中的常见误区与应对策略

高凯 (花名:岑坚)
......
淘天集团营销技术质量负责人,高级测试开发专家,2010年校招入职阿里,深耕电商质量工程16年。连续8届担任双11、618集团业务质量负责人(PTM),协调35+BU保障大促业务确定性;从0到1构建大促预演平台并推动SAAS化,打造"未来版淘宝"实现体验确定性前置。《阿里测试之道》联合作者。
近两年,带领团队全面转向AI原生质量工程,完整经历了专题所述的演进链路:从AI辅助用例生成与代码评审(测试左移),到数字员工自主执行会场验收、端智能路径规划(Agent自主执行),再到AI驱动的结果分析与问题定位、AI值守自主修复(测试右移)。大促端到端执行效率、深度超10倍提升,营销域验收人力投入降低80%,AI值守准确率、稳定性99.9%。同时定义了面向营销业务的智能体评测方法论,构建营销标准评测集,推动"AI评测AI"的新范式落地。
淘天集团 营销技术质量负责人
高级测试开发专家
待定
待定
从确定性到概率性——AI 原生时代,质量工程的范式重构
1. "确定性"?AI 天生不确定
2. 三块地基(可复现、可断言、可覆盖),同时在塌
3. 质量工程的三个范式迁移:断言→评测、点→分布、关卡→飞轮
4. 谁来评测那个评测者?
5. 评测正在从"工程需要"变成"制度义务"
6. 三个预判
7. 在概率的世界里,重建信任
2. 三块地基(可复现、可断言、可覆盖),同时在塌
3. 质量工程的三个范式迁移:断言→评测、点→分布、关卡→飞轮
4. 谁来评测那个评测者?
5. 评测正在从"工程需要"变成"制度义务"
6. 三个预判
7. 在概率的世界里,重建信任

张乐
腾讯 智能化软件工程资深技术专家
研发效能资深技术专家
负责支撑数万人规模的 AI Coding 及智能化工具平台的设计与研发、Harness Engineering 的设计与实现。曾先后就职于百度、京东等国内一线互联网企业及多家世界五百强公司,长期负责研发效能提升、研发效能度量体系建设、敏捷与DevOps实践落地及平台工程体系的研发工作。《研发效能宣言》发起人及主要内容起草人、《AI质效宣言》共同发起人,DevOps运动国内早期布道者与推动者。著作:《软件研发效能提升实践》、《软件研发效能权威指南》;译著:《独角兽项目:数字化转型时代的开发传奇》、《价值流动:数字化场景下软件研发效能与业务敏捷的关键》。知识星球“AI x 研发效能”主理人。
待定
待定
驭变而行:基于Harness构建高可靠的 AI 软件研发体系
AI 生成代码已大量进入生产环境,但模型输出的概率性决定了高可靠性无法依赖 Agent 的"自觉"——这正是 Harness 的出发点。AI 研发的竞争焦点正从模型扩展到驾驭工程(Harness Engineering):Claude Code 官方博客系统阐述了自身的 Harness 实践,DeepSeek 近期更开源了 DeepSeek Harness——共识随之清晰:模型只负责预测,Harness 才决定可靠性。Harness 由此抽象出六大要素——Rules 界定边界、Skills 封装能力、Sub-agents 分离职责、Hooks 强制把关、MCPs 打通外部系统、Memory 延续上下文。在此之上,我们以四层防线收束 Agent 行为:提示层界定意图、上下文层固化规则、工具层隔离权限、运行时层兜底拦截,约束随执行链路逐级增强。这套约束落到研发链路,便是将需求到交付重构为 Agent 接力的 Workflow:以流程铁律规范主控边界、多 Agent 制衡对抗保障输出质量、自主循环与可观测确保过程可控,再以分层质量门禁实现最终兜底。更进一步,在效能度量层面,AI 时代需要重构评估框架——从"代码产出的过程性指标,转向"人机协同"的结果性度量,让数据回答 Tokens消耗是否真正转化为有效产能。驭变而行,Harness 的意义正在于此:既要释放 AI 研发的效率,也要守住可靠性的研发底线。
关注QECon公众号
议题投稿
speaker@qecon.com.cn
商务合作
151-2264-3988 木子
票务联系
135-2067-8913 媛媛
媒体合作
135-1619-6409 皮皮
添加QECon小助手,获取
会议最新资讯
购票咨询
13520678913 媛媛