专场:可观测性驱动 Agent 质量演进与架构优化
在企业级 Agent 从 Demo 走向规模化生产的过程中,可观测性绝不应止步于“事故后的看图排障”。传统的 APM 指标无法评估智能体的决策优劣,而零散日志也难以解释“系统返回 200,但用户任务彻底失败”的假健康状态。如何精准定位异常?如何量化 Agent 过程质量?如何确保 Prompt、Tool 或模型升级后系统不发生隐形降级? 本专场聚焦 Agent 可观测性与质量闭环体系建设。我们将深入探讨如何打通 “全链路观测 ➔ 跨层因果归因(RCA) ➔ 失败样本回流 ➔ LLMs-as-a-Judge 过程评估 ➔ 自动化发布门禁” 的完整质量飞轮。 专场将包含一线落地实战经验:从基于 LLMs-as-a-Judge 的过程与结果双重评估(Rubrics 机制),到跨层因果链下的异常根因定位;从 Tool/MCP 循环与记忆截断的精准拦截,到线上 Trace 转化为离线回归测试集(Trace-to-Dataset)。我们旨在为 complex Agent 构建可复盘、可评估、可演进的质量底座,保障企业 Agent 规模化运行的稳定性与持续进化。
专场出品人:黄闻欣
腾讯 技术总监
自 2009 年加入腾讯以来,曾管理系统测试团队,技术垂直领域的性能专项团队和可观测 RUM / AI 工作台的业务团队,深耕技术管理和团队效能提升领域。作为大模型技术的深度实践者,通过将其融入日常管理流程,在团队协作、知识管理、绩效评估等关键场景取得显著成效。目前负责IaaS、数据库、元宝的性能工程工作和AI评估工作,探索将AI团队共脑与 AI 决策相结合的管理新模式,致力于用 AI 技术重塑传统管理模式,构建高效的团队价值传递体系。

王勇
58同城 高级研发工程师
58 同城高级研发工程师,深耕一线研发与效能领域多年,拥有多项 AI 技术发明专利。目前主要负责 AI 测试专项,主导通用测试 Agent 研发与落地,从零搭建包含智能用例生成、测试知识库、知识图谱、多 Agent 编排与观测能力的通用测试效能平台,长期聚焦 AI 赋能软件测试方向,持续推进测试智能化与研发效能提升。
待定
待定
从链路可观测到质量可信:通用测试 Agent 工程化实践
议题背景:
本分享围绕通用测试 Agent 的质量可信问题,介绍将动态执行转化为可审计、可证明结论的控制面实践。方案以责任契约为主线,通过执行数据采集、上下文关联与语义标准化,形成过程、决策和证据三类事实,结合结果证明与运行级对账,建立从测试责任到报告声明的完整链路。在计划、路由、执行、结果和报告五个环节设置强制控制点,让重试、超时和证据不足等情况直接影响执行行为与最终结论,确保质量声明有据可查,并展望跨运行复算与事实驱动的持续优化。
内容大纲:
1. 问题与边界:最终结果背后仍是执行黑盒
本分享围绕通用测试 Agent 的质量可信问题,介绍将动态执行转化为可审计、可证明结论的控制面实践。方案以责任契约为主线,通过执行数据采集、上下文关联与语义标准化,形成过程、决策和证据三类事实,结合结果证明与运行级对账,建立从测试责任到报告声明的完整链路。在计划、路由、执行、结果和报告五个环节设置强制控制点,让重试、超时和证据不足等情况直接影响执行行为与最终结论,确保质量声明有据可查,并展望跨运行复算与事实驱动的持续优化。
内容大纲:
1. 问题与边界:最终结果背后仍是执行黑盒
1.1 概率执行与确定性质量流程
1.2 Agent 自治与多 Agent 编排的执行复杂性
1.3 日志与可审计责任结论的差距
1.4 运行完成、执行进度与质量结论的边界
1.2 Agent 自治与多 Agent 编排的执行复杂性
1.3 日志与可审计责任结论的差距
1.4 运行完成、执行进度与质量结论的边界
2. 总体架构:从 Agent 执行到可信控制
2.1 责任契约:Obligation 贯穿整条可信链
2.2 通用测试 Agent:执行中枢与专业 Agent
2.3 可信质量链:从执行到正式报告
2.2 通用测试 Agent:执行中枢与专业 Agent
2.3 可信质量链:从执行到正式报告
3. 事实形成与对账判定
3.1 执行数据采集、关联与标准化
3.2 过程事实、决策事实与证据事实
3.3 结果证明与 Run 级对账
3.4 控制决策与报告声明复算
3.2 过程事实、决策事实与证据事实
3.3 结果证明与 Run 级对账
3.4 控制决策与报告声明复算
4. 强制控制:不可信结论怎样真的发不出去
4.1 五个控制点:计划、路由、执行、结果与报告
4.2 责任终态:Retry、Timeout 与 WAIVED
4.3 报告门禁:控制决策如何改变最终页面
4.2 责任终态:Retry、Timeout 与 WAIVED
4.3 报告门禁:控制决策如何改变最终页面
5. 总结与展望
5.1 可信控制实践总结
5.2 跨 Run 可复算与事实驱动的持续优化
5.2 跨 Run 可复算与事实驱动的持续优化
听众收益:
1. 理解通用测试 Agent 从“能跑”走向“可信”的关键矛盾:在 LLM 概率性、任务多样性和质量确定性要求之间,如何通过工程化约束提升 Agent 测试结果的可信度。
2. 掌握多 Agent 测试编排的通用设计思路:如何拆分用户入口、编排中枢、专业执行 Agent、统一协议、执行账本和证据体系,避免多 Agent 协作停留在简单能力堆叠。
3. 获得一套链路可观测驱动的 Agent 质量治理方法:通过 Trace 还原执行链路,通过结构化数据沉淀关键事实,通过证据索引支撑报告可信,通过 Eval/回归样本推动持续优化。
1. 理解通用测试 Agent 从“能跑”走向“可信”的关键矛盾:在 LLM 概率性、任务多样性和质量确定性要求之间,如何通过工程化约束提升 Agent 测试结果的可信度。
2. 掌握多 Agent 测试编排的通用设计思路:如何拆分用户入口、编排中枢、专业执行 Agent、统一协议、执行账本和证据体系,避免多 Agent 协作停留在简单能力堆叠。
3. 获得一套链路可观测驱动的 Agent 质量治理方法:通过 Trace 还原执行链路,通过结构化数据沉淀关键事实,通过证据索引支撑报告可信,通过 Eval/回归样本推动持续优化。

蔡丽珊
蚂蚁集团 高级测试开发工程师
多年从事 AI 质量技术、Agent 工程化、搜索推荐评测和业务质量保障工作。负责 AI 策略生成链路的 Evaluator 评测框架与可观测体系建设,完善产物校验、评估反馈、链路追踪能力;负责支付宝酒旅行业智能体评测,建设评测集、指标体系及归因机制;负责出行搜索推荐的离线评测、线上实时评测、特征及模型质量建设,以评测驱动算法优化和业务效果提升。同时具备酒店、文旅、机票、铁路等行业质量保障经验。
擅长领域:可观测性、智能体评测、搜索推荐、大模型及质量工程。
擅长领域:可观测性、智能体评测、搜索推荐、大模型及质量工程。
待定
待定
让 Agent 产出可验证、问题可定位:Evaluator 与全链路可观测实践
议题背景:
AI 策略生成已从单轮问答演进为 SuperAgent 编排多个 SubAgent、Tool 和 LLM 的长程任务,过程中持续产出多阶段 Artifact。传统接口测试只能判断流程是否结束,既难验证产物的结构、语义与跨阶段一致性,也难定位失败发生在模型、工具还是编排环节。本议题基于真实策略生成链路,分别介绍以 Artifact 为中心的 Evaluator 框架和以 Trace/Span 为中心的执行可观测体系,重点分享规则与模型的分工、证据与反馈闭环,以及异步并发下的链路归因和工程踩坑。
AI 策略生成已从单轮问答演进为 SuperAgent 编排多个 SubAgent、Tool 和 LLM 的长程任务,过程中持续产出多阶段 Artifact。传统接口测试只能判断流程是否结束,既难验证产物的结构、语义与跨阶段一致性,也难定位失败发生在模型、工具还是编排环节。本议题基于真实策略生成链路,分别介绍以 Artifact 为中心的 Evaluator 框架和以 Trace/Span 为中心的执行可观测体系,重点分享规则与模型的分工、证据与反馈闭环,以及异步并发下的链路归因和工程踩坑。
内容大纲:
1. 背景介绍—Agent 跑完了,产出就真的可用吗?
1.1 长程 Agent 的多阶段 Artifact 质量问题
1.2 SuperAgent、SubAgent、Tool 和 LLM 黑盒链路的定位难题
1.2 SuperAgent、SubAgent、Tool 和 LLM 黑盒链路的定位难题
2. 让产出可验证—以 Artifact 为中心的 Evaluator 框架
2.1 Artifact 驱动的评测触发与路由机制
2.2 硬约束规则与软约束 Evaluator Agent 的分层协同
2.3 独立 Evaluator SubAgent 的上下文隔离与证据边界
2.4 从检查项执行、结构化报告到 SuperAgent 反馈的评测闭环
2.2 硬约束规则与软约束 Evaluator Agent 的分层协同
2.3 独立 Evaluator SubAgent 的上下文隔离与证据边界
2.4 从检查项执行、结构化报告到 SuperAgent 反馈的评测闭环
3. 让问题可定位—以 Trace/Span 串起 Agent 执行链路
3.1 SuperAgent、SubAgent、Skill、Tool、MCP 和 LLM 全链路采集
3.2 基于远程流式响应的 SubAgent 内部 Span 反向构建
3.3 异步、并行、重试和多机执行下的 Trace 上下文治理
3.4 流式输出、历史日志、评测报告与 Trace 的关联展示
3.2 基于远程流式响应的 SubAgent 内部 Span 反向构建
3.3 异步、并行、重试和多机执行下的 Trace 上下文治理
3.4 流式输出、历史日志、评测报告与 Trace 的关联展示
4. 三个可复用的工程踩坑—评测和可观测为什么也会不可信?
4.1 Evaluator 不是事实源—用证据契约约束无依据的模型判断
4.2 Trace 上下文不等于线程上下文—避免异步并发下的串链与丢链
4.3 可观测数据也需要一致性设计—处理远程协议、双数据源合并与 Token 口径
4.2 Trace 上下文不等于线程上下文—避免异步并发下的串链与丢链
4.3 可观测数据也需要一致性设计—处理远程协议、双数据源合并与 Token 口径
5. 实践结果—从发现问题走向驱动 Agent 优化
5.1 形成覆盖策略生成关键环节的多类 Evaluator、数十项硬约束检查和十余项软约束 Skill
5.2 在十余个真实任务、数百次评测执行及数百条策略上验证评测与问题归因能力
5.3 通过规则、文件、策略和执行 Span 归因,反哺 Prompt、Skill 与编排优化
5.2 在十余个真实任务、数百次评测执行及数百条策略上验证评测与问题归因能力
5.3 通过规则、文件、策略和执行 Span 归因,反哺 Prompt、Skill 与编排优化
听众收益:
1. 掌握一套以 Artifact 为中心的 Agent Evaluator 设计方法,能够根据确定性、语义性和证据边界拆分硬约束、软约束及外部系统校验。
2. 理解 SuperAgent、SubAgent、Tool 和 LLM 全链路可观测的关键实现,获得处理异步并发、远程链路反向构建、实时与历史数据融合的工程经验。
1. 掌握一套以 Artifact 为中心的 Agent Evaluator 设计方法,能够根据确定性、语义性和证据边界拆分硬约束、软约束及外部系统校验。
2. 理解 SuperAgent、SubAgent、Tool 和 LLM 全链路可观测的关键实现,获得处理异步并发、远程链路反向构建、实时与历史数据融合的工程经验。
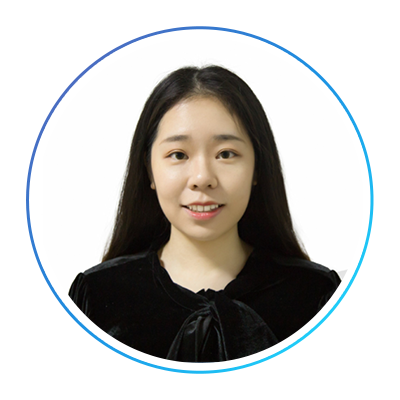
汪璐璐
腾讯音乐 高级专项测试工程师
工作7年,东南大学硕士,毕业后入职 TME,主要负责音视频算法、AI-Agent类测试开发工作。
目前在腾讯音乐负责算法效果类专项测试及主客观评估工具开发落地,包括音视频专项质量保障、AIGC 生成内容、AI-agen内容质量保障以及客观评测模型研发落地。研究方向包括算法效果类评测、主客观评价、评价标准&工具。
目前在腾讯音乐负责算法效果类专项测试及主客观评估工具开发落地,包括音视频专项质量保障、AIGC 生成内容、AI-agen内容质量保障以及客观评测模型研发落地。研究方向包括算法效果类评测、主客观评价、评价标准&工具。
待定
待定
从E2E到节点级:构建音乐 AI Agent 全链路可观测的质量保障体系
议题背景:
随着LLM在音乐场景的落地,传统QA手段面临失效:音乐Agent具有“黑盒推理+长链路调用”特性,单纯依赖端到端(E2E)测试往往只能判定“结果错”,却无法定位是意图理解偏差、工具调用失败还是知识库缺陷;同时,音乐审美的主观性导致评测标准难以量化,人工标注成本高且一致性差。本次分享将重点探讨如何构建“端到端结果校验+全链路过程监控”的双轨评测体系,通过链路Trace与节点级埋点,在守住最终用户体验底线的同时,将不可控的黑盒转化为可视化的白盒,实现从“知其错”到“知其所以错”的质变。
随着LLM在音乐场景的落地,传统QA手段面临失效:音乐Agent具有“黑盒推理+长链路调用”特性,单纯依赖端到端(E2E)测试往往只能判定“结果错”,却无法定位是意图理解偏差、工具调用失败还是知识库缺陷;同时,音乐审美的主观性导致评测标准难以量化,人工标注成本高且一致性差。本次分享将重点探讨如何构建“端到端结果校验+全链路过程监控”的双轨评测体系,通过链路Trace与节点级埋点,在守住最终用户体验底线的同时,将不可控的黑盒转化为可视化的白盒,实现从“知其错”到“知其所以错”的质变。
内容大纲:
1. 音乐AI Agent的评测困境与挑战
1.1 长链路黑盒化:单纯E2E测试只能看到表象结果,定位不到原因
1.2 主观与客观的博弈:如何定义agent效果好,缺少量化指标
1.2 主观与客观的博弈:如何定义agent效果好,缺少量化指标
2. 双轨评测体系的架构设计与演进
2.1 从单点到分层:构建“端到端兜底+过程链路拆解”的评测矩阵
2.2 评测平台整体架构:用例管理、调度引擎与数据采集层
2.2 评测平台整体架构:用例管理、调度引擎与数据采集层
3. 过程监控体系的搭建与节点级量化(★核心亮点)
3.1 链路拆解与埋点设计:意图识别准确率、工具调用参数合规性、知识检索召回率的指标定义
3.2 Trace全链路追踪:构建串联多模态日志,实现失败路径自动归因
3.3 工程落地坑点
3.2 Trace全链路追踪:构建串联多模态日志,实现失败路径自动归因
3.3 工程落地坑点
4. LLM-as-Judge 多Agent协同评估实践
4.1 评估Prompt工程:如何构建抗干扰、可复现的评判标准?
4.2 多模型交叉验证与人工标注对齐策略,降低幻觉评分
4.2 多模型交叉验证与人工标注对齐策略,降低幻觉评分
5. 跨端异构环境的自动化采集与归一化(★升级重点)
抽象底层驱动层,无缝切换iOS/Android/HarmonyOS三大生态的方案
6. 落地收益与总结展望
6.1 量化收益:评测效率提升300%,缺陷定位准确率提升至90%+
6.2 质量改进:从“感性吐槽”到“数据驱动”的产品迭代闭环
6.2 质量改进:从“感性吐槽”到“数据驱动”的产品迭代闭环
听众收益:
1.掌握“E2E+链路”双轨评测方法论:学习如何在保证端到端结果正确的前提下,通过过程监控实现精准归因,解决黑盒Agent的根因定位难题。
2.获取跨端自动化采集的通用方案:了解如何在iOS、Android、鸿蒙等多系统间构建统一的采集与适配层,规避碎片化环境下的重复开发成本。
3.获得LLM自动化评估实战经验:获取Prompt设计、多模型交叉验证及评分校准的一手经验,规避人工评估一致性差的陷阱。
1.掌握“E2E+链路”双轨评测方法论:学习如何在保证端到端结果正确的前提下,通过过程监控实现精准归因,解决黑盒Agent的根因定位难题。
2.获取跨端自动化采集的通用方案:了解如何在iOS、Android、鸿蒙等多系统间构建统一的采集与适配层,规避碎片化环境下的重复开发成本。
3.获得LLM自动化评估实战经验:获取Prompt设计、多模型交叉验证及评分校准的一手经验,规避人工评估一致性差的陷阱。
关注QECon公众号
关注QECon视频号
商务合作
151-2264-3988 木子
票务联系
159-0126-5561 小娟
媒体合作
135-1619-6409 皮皮

购票咨询
小娟 15901265561